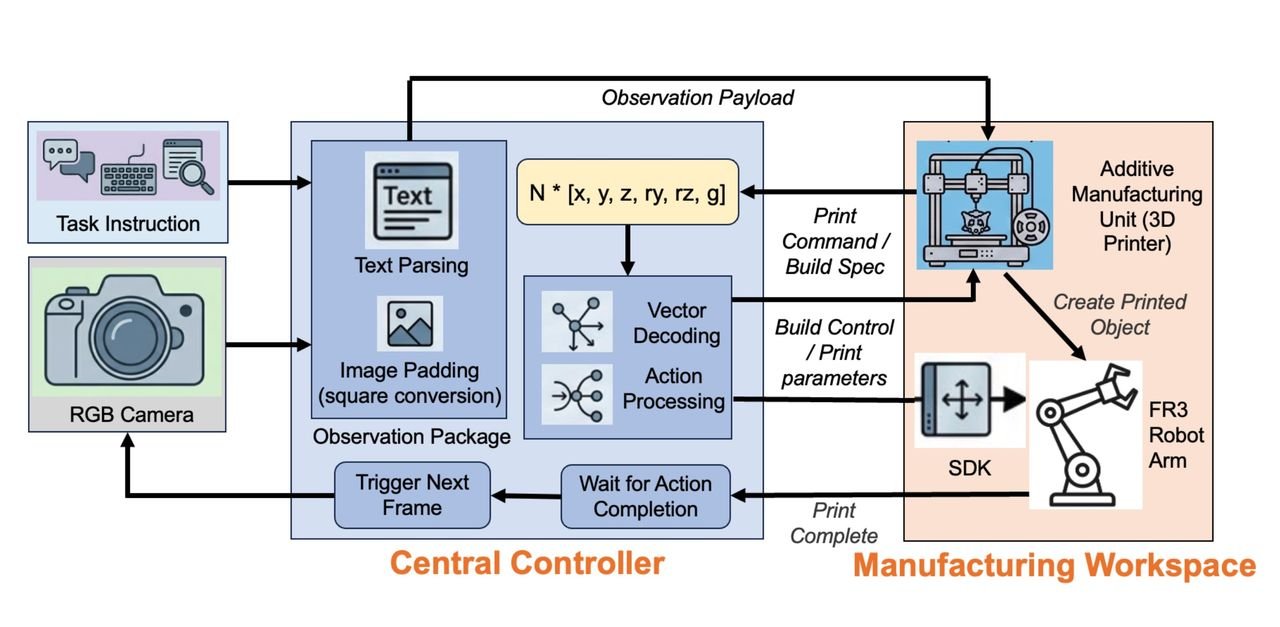
عرض باحثون من عدة جامعات أمريكية نظامًا تجريبيًا باسم ChunkVLA-AM لربط نموذج رؤية ولغة وحركة بذراع روبوتية FAIRINO FR3، بهدف تمهيد الطريق لأتمتة مهام ما بعد الطباعة من خلال أوامر قصيرة بدل برمجة كل حركة يدويًا.
ثماني حركات في كل طلب
بدل أن يطلب النظام حركة واحدة ثم يلتقط صورة جديدة، يتنبأ بثماني خطوات متتابعة في كل مرة. ينفذ الروبوت هذه المجموعة، ثم تلتقط كاميرا RGB صورة جديدة للحصول على المجموعة التالية. وتشمل الأوامر تغيير الموضع والدوران وحركة الماسك، مع قواعد أمان ترفض المسارات الخارجة عن نطاق العمل أو القريبة أكثر من اللازم.
39 نجاحًا من 42 تجربة
في الاختبار الفعلي، طُلب من الروبوت التقاط كتلة حمراء أو زرقاء ونقلها بين نقطتين. نجح في 39 من 42 محاولة، أي 92.9%، وسجل متوسط خطأ موضعي 1.74 مم. حدثت الإخفاقات الثلاثة عند وضع القطعة بسبب عدم دقة ارتفاع التحرير، كما أثرت الإضاءة القوية جدًا أو الضعيفة في النتائج.
المهم إن التجربة لم تُزل قطعة مطبوعة حقيقية من منصة طباعة حتى الآن؛ نقل الكتل كان نموذجًا مبسطًا للمهمة. لذلك الحديث عن إزالة الطبعات الفاشلة أو فحص الالتواء ما زال اتجاهًا مستقبليًا، وليس وظيفة جاهزة لمزارع الطابعات. تابع أخبار الأتمتة والطباعة ودليل الطابعات.
المصدر: Fabbaloo — تاريخ النشر: 7 أكتوبر 2026. البحث الأصلي: arXiv — أُرسل في 1 أكتوبر 2026.